Actualizado el: 30 de octubre de 2026
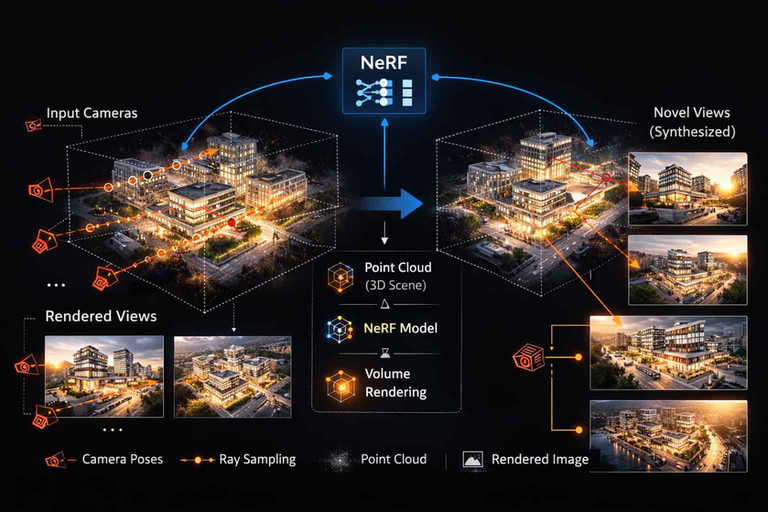
Un campo de radiancia neuronal (NeRF, por Neural Radiance Field) es una forma de convertir un conjunto de fotos normales de una escena real en una escena 3D que se puede ver desde ángulos nuevos. Una red neuronal aprende, a partir de fotos tomadas desde posiciones de cámara conocidas, el color y la densidad de cada punto del espacio, y el renderizado volumétrico dibuja después vistas que la cámara nunca tomó. NeRF lo presentaron Mildenhall, Srinivasan, Tancik, Barron, Ramamoorthi y Ng en su artículo de ECCV 2020 y es uno de los métodos más conocidos del renderizado neuronal.
Desde 2023, un segundo método, el 3D Gaussian Splatting, guarda la escena como gaussianas 3D explícitas en lugar de una red y la muestra en tiempo real; muchas herramientas de captura ya lo ofrecen, y a ambos se los agrupa a menudo como campos de radiancia (radiance fields). Esta guía explica cómo funciona NeRF en cuatro pasos, en qué se diferencia del Gaussian splatting, la fotogrametría y el escaneo láser, dónde los encuentra un arquitecto y qué herramientas los crean en octubre de 2026.
Cómo funciona NeRF en cuatro pasos
El artículo original describe NeRF como una red totalmente conectada que recibe "una única coordenada 5D continua", una posición y una dirección de visión, y devuelve la densidad volumétrica y el color dependiente de la vista; las imágenes se obtienen de ella con el renderizado volumétrico clásico. En la práctica, todo se reduce a cuatro pasos.
Paso 1: fotos y poses de cámara
El entrenamiento parte de un conjunto de fotos de la escena tomadas desde muchas posiciones, más la posición y la orientación de cada cámara (su pose). Para escenas reales, el NeRF original estimó las poses con un software de structure-from-motion (COLMAP); los sistemas SLAM son otra fuente, y algunas variantes posteriores ajustan las poses durante el entrenamiento. La cobertura importa más que el número de fotos: las partes de la escena vistas desde pocos ángulos salen borrosas o incompletas.
Paso 2: rayos y puntos de muestreo
Para cada píxel, NeRF lanza un rayo desde la cámara hacia la escena y elige puntos de muestreo a lo largo de él. El método original usa primero una red gruesa para encontrar dónde está el contenido y después coloca más muestras allí para una red fina. Este muestreo jerárquico dedica el cálculo a las superficies en lugar de al aire vacío.
Paso 3: la red predice densidad y color
La posición de cada muestra (x, y, z) y la dirección de visión del rayo entran en un perceptrón multicapa (MLP). La red devuelve dos valores: la densidad volumétrica, cuánta materia u opacidad hay en ese punto, y el color dependiente de la vista, que permite que los reflejos y los brillos cambien cuando se mueve la cámara. Antes de entrar en la red, las coordenadas pasan por una codificación posicional, senos y cosenos a varias frecuencias, una forma de mapeo de características de Fourier que permite a la red aprender bordes nítidos y texturas finas.
Paso 4: renderizado volumétrico y entrenamiento
Los colores de las muestras de un rayo se mezclan, ponderados por su densidad, en un solo color de píxel. A diferencia del ray tracing, que comprueba los rayos contra superficies explícitas como triángulos, NeRF resuelve la visibilidad con la densidad acumulada a lo largo del rayo, de modo que la oclusión y los bordes suaves salen de forma natural. Como este paso de renderizado volumétrico es diferenciable, la diferencia entre cada píxel renderizado y la foto real se lleva de vuelta a los pesos de la red mediante descenso de gradiente; repetido en muchos rayos, la red aprende la escena y después puede renderizar vistas desde posiciones de cámara nuevas.
NeRF no simula la luz como el path tracing calcula la iluminación global: reproduce la luz que había en las fotos.
Geometría, profundidad e iluminación en un NeRF
NeRF no guarda superficies: ni malla, ni nube de puntos, ni función de distancia con signo. La geometría está implícita en el campo de densidad aprendido, y se puede estimar un valor de profundidad donde la densidad a lo largo de un rayo alcanza su máximo. Eso da pistas útiles, pero no es métricamente preciso, así que la geometría que se obtiene de un NeRF es una aproximación, no un levantamiento.
La iluminación queda fija. NeRF no modela fuentes de luz ni la reflectancia de los materiales; reproduce la escena con la luz de las fotos de entrenamiento, con brillos que cambian según la dirección de visión. Cambiar la iluminación o un material requiere métodos ampliados, algo importante si quieres usar una captura para estudios de luz o de materiales.
NeRF más rápidos: Instant NGP, TensoRF y PlenOctrees
El NeRF original es costoso de calcular: consulta la red en cada muestra de cada rayo, tanto en el entrenamiento como para cada vista nueva. Tres métodos muestran cómo se redujo ese costo:
Instant NGP (Müller, Evans, Schied y Keller, NVIDIA, SIGGRAPH 2022) combina una red pequeña con una codificación hash multirresolución; su artículo indica un entrenamiento "en cuestión de segundos" y un renderizado "en decenas de milisegundos" a 1920×1080.
TensoRF (ECCV 2022) factoriza el campo de radiancia en componentes tensoriales compactos, para una reconstrucción más rápida y modelos más pequeños.
PlenOctrees (Yu, Li, Tancik, Li, Ng y Kanazawa, ICCV 2021) convierte un NeRF ya entrenado en un octree para mostrarlo en tiempo real: más de 150 fotogramas por segundo a 800×800, que según sus autores es más de 3000 veces más rápido que los NeRF convencionales.
La misma búsqueda de velocidad llevó al 3D Gaussian Splatting.
NeRF frente a Gaussian splatting
El 3D Gaussian Splatting (3DGS; Kerbl, Kopanas, Leimkühler y Drettakis, SIGGRAPH 2023) aprende una escena a partir de los mismos datos que NeRF, fotos con poses de cámara, pero la guarda de otra forma. Parte "de los puntos dispersos que se obtienen durante la calibración de la cámara", los convierte en gaussianas 3D, pequeños elipsoides difusos con una posición, una forma (covarianza anisótropa), una opacidad y un color, y los ajusta hasta que las vistas renderizadas coinciden con las fotos. Para ver dónde encajan ambos métodos entre otros algoritmos de renderizado, de la rasterización a los modelos de difusión, consulta nuestra guía general.
| NeRF | 3D Gaussian Splatting |
|---|---|---|
Presentado | Mildenhall et al., ECCV 2020 | Kerbl et al., SIGGRAPH 2023 |
Cómo se guarda la escena | De forma implícita, en los pesos de una red neuronal | De forma explícita, como un gran conjunto de gaussianas 3D |
Datos de entrada | Fotos con poses de cámara conocidas | Fotos con poses de cámara conocidas y los puntos dispersos de la calibración de cámara |
Cómo se dibuja una vista | Renderizado volumétrico: se consulta la red en muchas muestras de cada rayo | Las gaussianas se proyectan en la pantalla (splatting) con un rasterizador que tiene en cuenta la visibilidad |
Velocidad de visualización | Original: lejos del tiempo real; Instant NGP: decenas de milisegundos por vista de 1920×1080 | Tiempo real: 100 fps o más a 1080p, según el artículo |
Edición | Difícil: los cambios requieren reentrenar o métodos de edición especiales | Más fácil: las gaussianas son explícitas y se pueden seleccionar, mover o borrar |
Formato de intercambio | Pesos de la red, leídos por el software que la entrenó | Una extensión de glTF, KHR_gaussian_splatting, publicada como versión candidata el 3 de febrero de 2026 |
Geometría medible | No: la geometría se deduce de la densidad | No: las gaussianas aproximan las superficies, pero no son un levantamiento |
Red neuronal | Sí | No en el método original |
¿Por qué el Gaussian splatting es más rápido que NeRF?
NeRF ejecuta su red en muchos puntos de cada rayo para dar color a cada píxel. El Gaussian splatting no tiene una red que evaluar por píxel: la escena ya es una lista de gaussianas con sus colores, y un rasterizador hecho para ellas las proyecta y las mezcla en la GPU. Por eso el artículo original alcanza 100 fotogramas por segundo o más a 1080p, cuando el NeRF original estaba lejos del tiempo real.
¿Es preciso el Gaussian splatting?
Visualmente, puede quedar muy cerca de las fotos desde los puntos de vista capturados, y pierde calidad lejos de ellos. Geométricamente, no es un levantamiento: las gaussianas aproximan las superficies, y la captura no tiene una escala real fiable hasta que se vincula a puntos medidos. Lo mismo vale para NeRF.
¿NeRF y el Gaussian splatting necesitan LiDAR?
No. Ambos métodos solo necesitan fotos o fotogramas de video y las poses de cámara calculadas a partir de ellos. Se pueden añadir LiDAR o puntos topográficos a una captura para fijar su escala o ayudar a alinearla, pero ninguno de los dos métodos los exige.
¿El Gaussian splatting se considera IA?
En el sentido amplio de aprendizaje automático, sí: las gaussianas se optimizan por descenso de gradiente para que coincidan con las fotos, igual que se entrena una red. Pero el 3DGS original no usa ninguna red neuronal, mientras que NeRF sí es una. Ninguno de los dos métodos diseña nada: ambos reproducen un lugar que se fotografió.
NeRF, fotogrametría y escaneo láser
La fotogrametría también parte de fotos superpuestas, pero produce geometría explícita, una nube de puntos y una malla texturizada que se pueden medir una vez que el modelo está escalado. El escaneo láser mide distancias directamente y produce las nubes de puntos en las que se apoyan los levantamientos del estado actual y el trabajo de scan-to-BIM. NeRF y los splats gaussianos buscan reproducir cómo se ve un lugar desde cualquier ángulo, incluidos el vidrio y los reflejos; su geometría es deducida y su escala no es fiable, lo que limita su uso directo en ingeniería o construcción.
¿Es mejor el Gaussian splatting que la fotogrametría?
No es mejor, es distinto. Los splats y los NeRF están hechos para reproducir lo que muestran las fotos, incluidos los efectos que cambian con el ángulo de visión; la fotogrametría y el escaneo láser están hechos para dar una geometría que se puede medir, acotar y llevar a CAD o BIM. Los métodos se pueden combinar: un escaneo para las medidas y un splat o un NeRF para el aspecto.
Cuando el objetivo es un plano que se pueda acotar, una captura es solo una referencia. Toma las medidas clave de un levantamiento o mídelas en obra y después dibuja el plano en Floor Plan Maker: dibujas muros, puertas, ventanas y habitaciones en un navegador de escritorio, calibras la escala a partir de una longitud conocida, añades cotas y ves el área de cada habitación mientras las longitudes de los muros y las medidas de los muebles aparecen en pantalla, como en un programa CAD, ves el plano en 3D o lo recorres, y exportas en DXF, SVG, PDF, PNG, GLB u OBJ. Dibujar, editar, la vista 3D y las exportaciones son gratis.
NeRF a gran escala: Mega-NeRF y Block-NeRF
El NeRF original sirve para escenas acotadas, un objeto o una habitación que cabe en una sola red. Un campus o una manzana urbana desbordan una sola red en memoria, tiempo de entrenamiento y cobertura de vistas, así que los métodos a gran escala dividen la escena en regiones, cada una con su propio submodelo, y consultan solo las regiones que atraviesa un rayo.
Mega-NeRF
Mega-NeRF (Turki, Ramanan y Satyanarayanan, Universidad Carnegie Mellon, CVPR 2022) modela edificios o varias manzanas a partir de miles de imágenes tomadas sobre todo con drones. Agrupa los píxeles de entrenamiento por su geometría en submódulos que se entrenan en paralelo. Sus autores indican un entrenamiento 3 veces más rápido y un PSNR (una medida de calidad de imagen) un 12 % mayor que los métodos NeRF convencionales, y un renderizado 40 veces más rápido para recorridos interactivos.
Block-NeRF
Block-NeRF es una investigación de Waymo (Tancik, Casser, Yan, Pradhan, Mildenhall, Srinivasan, Barron y Kretzschmar, CVPR 2022). Renderiza un barrio entero de San Francisco, construido a partir de 2.8 millones de imágenes captadas por vehículos durante meses en condiciones ambientales distintas. Cada bloque se entrena por separado; las incrustaciones de apariencia por imagen, el ajuste aprendido de las poses y la exposición controlable manejan los cambios de luz y de clima, y la apariencia de los bloques vecinos se alinea para que se unan sin cortes. Waymo lo clasifica como investigación de percepción y simulación.
NeRF dinámicos: escenas que se mueven
El NeRF original supone que la escena no cambia: una persona que cruza la captura sale borrosa o rota. Los NeRF dinámicos, o deformables, añaden el tiempo como entrada, por eso también se llaman NeRF 4D, de modo que el campo puede representar:
objetos en movimiento, como personas y vehículos
formas que se deforman o se articulan
una apariencia que cambia a lo largo de una secuencia
Se usan sobre todo en investigación, animación y captura de actuaciones. Para un edificio o un interior, la solución práctica es capturarlo cuando nada se mueve y la luz se mantiene estable.
NeRF y otras representaciones neuronales de escenas
NeRF pertenece a una familia de representaciones neuronales de escenas. Las funciones de distancia con signo describen la distancia a la superficie más cercana y sirven para una geometría precisa; las redes de ocupación modelan si un punto está dentro o fuera de un objeto; NeRF modela la apariencia mediante renderizado volumétrico. Los métodos híbridos los combinan para equilibrar la precisión geométrica y la calidad visual.
NeRF y splats gaussianos en arquitectura y construcción
En arquitectura, ingeniería y construcción, los campos de radiancia capturan lo que ya existe y lo muestran desde cualquier ángulo. Ejemplos en octubre de 2026:
Mapas. Google anunció Immersive View para Google Maps el 8 de febrero de 2023, con NeRF para convertir fotos normales en representaciones 3D, primero en Londres, Los Ángeles, Nueva York, San Francisco y Tokio; en junio de 2023, Google Research explicó cómo reconstruye espacios interiores con NeRF a partir de fotos tomadas con cámaras réflex.
Plataformas geoespaciales y un estándar. Khronos publicó KHR_gaussian_splatting, una extensión de glTF 2.0 que guarda las gaussianas con su posición, orientación, escala, color y opacidad, como versión candidata el 3 de febrero de 2026. Su anuncio nombra a CesiumJS, Esri ArcGIS, Scaniverse de Niantic Spatial y XGRIDS como primeros adoptantes, llama a la extensión un componente clave del futuro OGC 3D Tiles 2.0 y muestra levantamientos con dron procesados en Esri ArcGIS Reality como una capa de splats gaussianos 3D.
Motores de render. V-Ray 7 incluye la reiluminación de splats gaussianos, de modo que los splats capturados se pueden usar dentro de escenas de V-Ray.
Estado actual y gemelos digitales. Una captura de un terreno, una calle o un interior antes de una reforma da al equipo y al cliente un registro visual que pueden recorrer, y puede servir como capa visual de un gemelo digital; para las medidas sigue haciendo falta un levantamiento.
Fuera de la construcción, los mismos métodos se investigan en imagen médica y se usan en realidad virtual y efectos visuales.
De una vista capturada a un render de presentación
Una captura muestra el edificio tal como es. Para mostrar la propuesta, con materiales nuevos, otra fachada u otra luz, haz una captura de pantalla de una vista en tu visor de NeRF o de splats y súbela al generador de renders con IA como JPG, PNG o WebP de hasta 5 MB. ArchiVinci genera en segundos una imagen nueva que sigue tu vista, con los materiales y la luz que describas en una frase; no crea ni edita la captura 3D. El motor predeterminado, ArchiVinci 4.0, mantiene la perspectiva y la geometría de tu vista, así que la propuesta aparece en su entorno real. Usar las imágenes para clientes requiere un plan activo.
El ejemplo de abajo parte de una imagen de una casa toda en blanco, no de una captura; los mismos pasos sirven para cualquier vista que subas.

Izquierda: la imagen subida. Derecha: el resultado en el módulo Exterior del prompt "Modern house with white plaster walls, timber cladding on the upper floor, large glass openings, a lawn and a few trees." con el botón Luz diurna y el motor predeterminado.
Convierte una vista capturada en una imagen de presentación Sube una captura de pantalla de una vista, una foto o un boceto y describe los materiales y la luz: ArchiVinci genera en segundos una imagen nueva que sigue tu archivo. Una cuenta nueva empieza con 3 créditos gratis. |
Herramientas para crear un NeRF o un Gaussian splat en 2026
Las herramientas de abajo se revisaron en sus propias páginas en octubre de 2026; los precios se dejan fuera porque cambian.
Herramienta | Qué crea | Cómo funciona |
|---|---|---|
NeRF (Nerfacto, su método recomendado, e Instant-NGP) y splats gaussianos (Splatfacto); exportación de geometría y guías de exportación para Blender, Maya y Unreal Engine | Framework de código abierto | |
Instant NGP | NeRF con la codificación hash multirresolución de NVIDIA | Código de investigación en GitHub (enlazado más arriba) |
Escenas de campos de radiancia a partir de imágenes RGB normales | Funciona en local en Windows 10 o posterior con una GPU NVIDIA de capacidad de cómputo 7.5 o superior (clase RTX 2060 en adelante); integración con Unreal Engine y After Effects; descarga gratuita y planes de pago | |
Splats gaussianos 3D | Una herramienta de Gaussian splatting con prueba gratuita de 7 días |
Conclusiones clave
NeRF aprende una escena a partir de fotos con poses de cámara conocidas y renderiza vistas nuevas mediante renderizado volumétrico.
La escena vive en una red neuronal, no en una malla ni en una nube de puntos; la geometría y la profundidad son deducidas y aproximadas.
La iluminación queda fija: cambiar la luz o los materiales requiere métodos ampliados.
Instant NGP, TensoRF y PlenOctrees hicieron rápido a NeRF; Mega-NeRF y Block-NeRF lo llevan a manzanas urbanas y a un barrio entero.
El 3D Gaussian Splatting (2023) guarda gaussianas explícitas y se muestra en tiempo real; muchas herramientas de captura de 2026 se basan en él.
Para una geometría medible, usa fotogrametría o escaneo láser; los NeRF y los splats muestran cómo se ve un lugar.
Pruébalo en ArchiVinci
Describe un edificio en una frase, o sube un boceto o una vista de tu modelo 3D: ArchiVinci genera imágenes de concepto que lo siguen. Una cuenta nueva empieza con 3 créditos gratis.
Para los primeros conceptos: Conceptos de arquitectura con IA
Renderiza un boceto, una foto o una vista 3D: IA para renders
Preguntas frecuentes
¿Qué significa NeRF?
NeRF son las siglas en inglés de Neural Radiance Field, campo de radiancia neuronal (en plural, Neural Radiance Fields o NeRFs): "neuronal" porque una red neuronal guarda la escena y "campo de radiancia" porque describe la luz, la radiancia, que cada punto del espacio emite en cada dirección. El nombre viene del artículo de 2020 de Mildenhall y sus colegas; en gráficos por computadora no tiene nada que ver con el término de videojuegos "nerfear".
¿Se sigue usando NeRF en 2026?
Sí, en investigación y en herramientas como Nerfstudio, cuyo método recomendado, Nerfacto, es un NeRF; Google anunció Immersive View en 2023 como basado en NeRF. Pero muchas herramientas de captura de 2026 ofrecen Gaussian splatting, que se muestra en tiempo real y tiene una extensión de glTF, y el propio Nerfstudio incluye los dos.
¿Se pueden editar escenas NeRF después del entrenamiento?
Las escenas NeRF no son directamente editables como los modelos 3D tradicionales. La geometría y la apariencia están codificadas implícitamente en los pesos de la red, lo que significa que la eliminación de objetos, cambios de materiales o ediciones localizadas generalmente requieren reentrenamiento o técnicas especializadas de edición NeRF en lugar de herramientas 3D estándar.
¿Se pueden convertir las salidas de NeRF en mallas o modelos CAD?
No existe una conversión directa ni sin pérdidas de NeRF a formatos de malla o CAD. Se puede extraer una superficie aproximada del campo de densidad, y Nerfstudio documenta una exportación de geometría para ello, pero la malla resultante suele tener ruido y no sirve para flujos de ingeniería o de fabricación.
¿Cuántas imágenes se necesitan para entrenar un NeRF confiable?
El desempeño de NeRF depende fuertemente de la cobertura de vistas. Si bien es posible entrenar con un número pequeño de imágenes, los puntos de vista limitados a menudo generan artefactos visuales, geometría faltante o regiones borrosas. La reducción de requisitos de datos sigue siendo un tema de investigación activa.
¿Cómo maneja NeRF escenas con objetos en movimiento?
El NeRF estándar supone una escena estática. Cuando hay movimiento, los elementos dinámicos suelen salir borrosos o reconstruidos de forma incoherente. Para modelar de forma fiable el movimiento, la deformación o los cambios en el tiempo hacen falta variantes especializadas de NeRF dinámicos o deformables.
¿Por qué NeRF no se usa ampliamente en motores de juegos en tiempo real?
NeRF se basa en el renderizado volumétrico y no en la rasterización, lo que lo hace costoso de mostrar, y le falta lo que esperan los motores de videojuegos: geometría explícita, gestión de colisiones y una edición sencilla. Nerfstudio tiene guías de exportación para Unreal Engine, y los splats gaussianos llegan a los motores con más facilidad mediante complementos como la integración de Jawset Postshot con Unreal Engine. Aun así, un splat es una capa visual sin colisiones ni física propias.